第八章 成对数据的统计分析
8.1 成对数据的相关关系
1.相关关系
两个变量有关系,但又没有确切到可由其中的一个去精确地决定另一个的程度的关系。
2.函数关系与相关关系的异同点
(1)相同点:均为两个变量之间的关系。
(2)不同点:相关关系:非确定,函数关系:确定。
3.正相关(负相关)
从整体上看,当一个变量的值增加时,另一个变量的相应值也呈现增加(减少)的趋势,称这两个变量正相关(负相关)。
4、两个变量的线性相关
(1)散点图
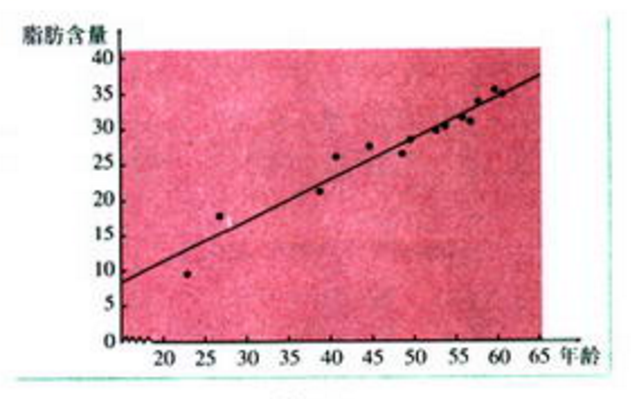
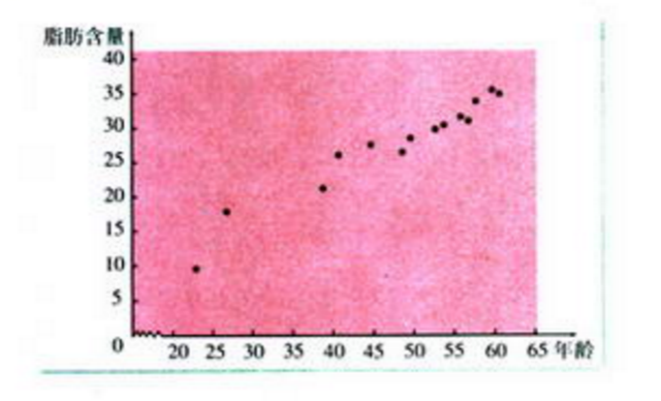
这些点大致分布在通过散点图中心()的一条直线附近。
5.线性相关
如果散点图中点的分布从整体上看大致在一条直线附近,我们就称这两个变量之间具有线性相关关系,这条直线叫回归直线。
(1)一般地,如果两个变量具有相关性,但不是线性相关,那么我们就称 这两个变量非线性相关或曲线相关。
1.对于变量x和变量y,设经过随机抽样获得的成对样本数据为(,),(,),…,(,),其中,,…,和,,…,的均值分别为和 .将数据以(,)为零点进行平移,得到平移后的成对数据为(),(),…,(),并绘制散点图。
2.利用散点()(i=1,2,…,n)的横、纵坐标是否同号,可以构造一个量
(1)一般情形下,>0表明成对样本数据正相关;<0表明成对样本数据负相关。
3.样本相关系数
为了消除度量单位的影响,需要对数据做进一步的“标准化”的处理,仿照的构造方法得到
我们称r为变量x和变量y的样本相关系数。
(1)样本相关系数r是一个描述成对样本数据的数字特征,它的正负性和绝对值的大小可以反映出成对样本数据的变化特征
①当r>0时,称成对样本数据正相关;
②当r<0时,称成对样本数据负相关。
(2)样本相关系数r的取值范围:-1≤r≤1
(3)当|r|=1时,表明成对样本数据都落在直线上,即两个变量之间满足一种线性关系。
(4)样本相关系数的意义:r的绝对值反映成对数据之间线性相关的程度。
(5)当|r|越接近1时,成对数据的线性相关程度越强;当|r|越接近0时,成对数据的线性相关程度越若。
8.2 一元线性回归模型及其应用
1.Y关于x的一元线性回归模型
(1)Y称为因变量或响应变量,x称为自变量或解释变量;
(2)a和b为模型的未知参数,a称为截距参数,b称为斜率参数;e是Y与bx+a之间的随机误差。
1.经验回归方程
=x+
记 ,
我们将=x+称为Y关于x的经验回归方程,也称经验回归函数或经验回归公式,其图形称为经验回归直线,这种求经验回归方程的方法叫做最小二乘法,求得的叫做b,a的最小二乘估计。
2.残差分析
(1)对于响应变量Y,通过观测得到的数据称为观测值,通过经验回归方程得到的称为预测值,观测值减去预测值称为残差。残差是随机误差的估计结果,通过对残差的分析可以判断模型刻画数据的效果,以及判断原始数据中是否存在可疑数据等,这方面工作称为残差分析。
(2)残差的散点图:比较均匀地集中在以横轴为对称轴的水平带状区域内,则满足一元线性回归模型对随机误差的假设。
(3) ,在表达式中,与经验回归方程无关,残差平方和与经验回归方程有关。
3.一元线性回归方程一定过样本中心点()
4.在使用经验回归方程进行预测时,需注意
(1)经验回归方程只适用于我们所研究的样本的总体。
(2)我们所建立的经验回归方程一般都有时间性。
(3)在样本数据中的响应变量的取值范围内,经验回归方程的预报效果好。
(4)不能期望经验回归方程得到的预报值就是响应变量的精确值。
8.3 分类变量与列联表
1.分类变量
在讨论问题时,为了表述方便,常会使用一种特殊的随机变量,以区别不同的现象或性质,这类随机变量称为分类变量。
2.2×2列联表
表是关于分类变量X和Y的抽样数据的2×2列联表:最后一行的前两个数分别是事件{Y=0}和{Y=1}的频数;最后一列的前两个数分别是事件{X=0}和{X=1}的频数;中间的四个数abcd是事件{X=x,Y=y} (x,y=0,1)的频数;n是样本容量。
| X | Y | Y | 合计 |
| X | Y=0 | Y=1 | 合计 |
| X=0 | a | b | a+b |
| X=1 | c | d | c+d |
| 合计 | a+c | b+d | n=a+b+c+d |
3.两个分类变量之间关联关系的定性分析的方法
(1)频率分析法:通过对样本的每个分类变量的不同类别事件发生的频率大小进行比较来分析分类变量之间是否有关联关系。
(2)图形分析法:常用等高堆积条形图展示列联表数据的频率特征。
1.提出零假设(原假设)$H_{0}$
分类变量X和Y独立,假定我们通过简单随机抽样得到了X和Y的抽样数据列联表,在列联表中,如果零假设成立,则应满足,即ad-bc≈0,。因此|ad-bc|越小,说明两个分类变量之间关系越弱;反之,越强。
为了使不同样本容量的数据有统一的评判标准,基于上述分析,我们构造一个随机变量
2.临界值
对于任何小概率值α,可以找到相应的正实数,使得P(x2≥xa)=α成立,我们称xa为α的临界值,这个临界值可作为判断x2大小的标准,概率值α越小,临界值xa越大。